 N環球

Google、オフライン音声認識とテキスト読み上げを AI Edge Gallery に追加
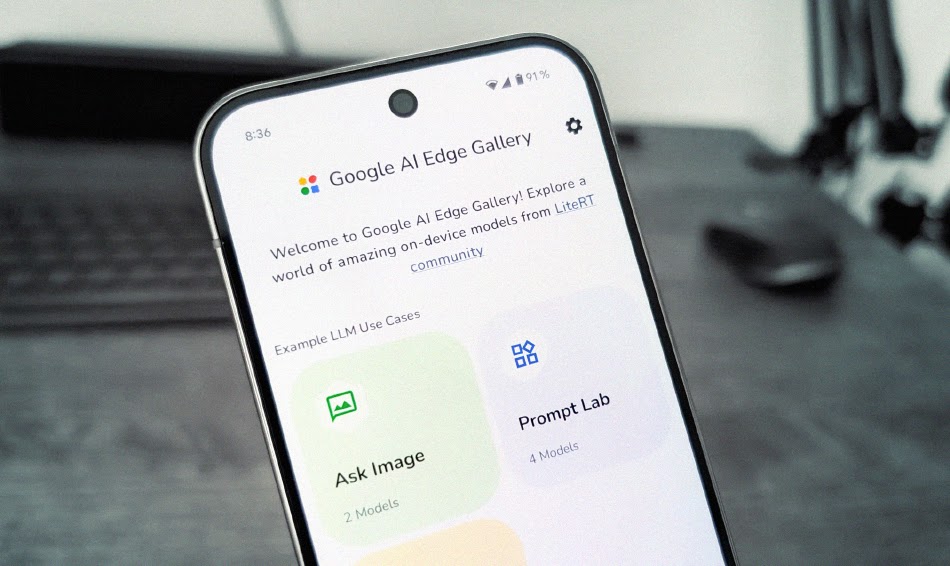
Googleは11月10日、AI Edge Galleryがオンデバイスのオフライン自動音声認識とテキスト読み上げをサポートし、Gemini NanoやGemma 4などの小型オンデバイスモデルと組み合わせて、ネットワーク接続なしで携帯電話が音声を文字に起こし、返信を読み上げられるようになったと発表した。
Google は 11 月 10 日、AI Edge Gallery が、Gemini Nano や Gemma 4 などの小規模なオンデバイス言語モデルと組み合わせて、オンデバイスの自動音声認識 (ASR) とテキスト読み上げ (TTS) をサポートするようになったと発表しました。これにより、ネットワークに接続しなくても、携帯電話で音声をライブで書き起こし、音声応答を合成できるようになります。 Googleは、音声は多くの場合、電話やウェアラブルでAIと対話する最も自然な方法であり、コンパクトな音声モデルの進歩により、正確な多言語ASRと表現力豊かなTTSがデバイス上で完全に可能になったと述べた。
Android: ML Kit は 100 以上の言語をカバーし、約 100 ミリ秒で話し始めます
Android では、ML Kit の最新のオンデバイス音声モデルは 10 倍のリアルタイム速度で 100 以上の言語を書き起こし、FLEURS ベンチマークでの単語エラー率は 8.0% ~ 9.0% に達します。コンパクトな数ステップの拡散モデルを活用したそのテキスト読み上げモデルは、約 100 ミリ秒で話し始め、8 つの表現力豊かな音声と 21 のロケールにわたって、最大 50 倍のリアルタイム速度で 24 kHz オーディオを合成します。どちらのモデルもオペレーティング システムに統合されており、アプリの APK に 0 MB が追加され、利用可能な場合は NPU および TPU バックエンドでのハードウェア アクセラレーションの恩恵を受けます。
クロスプラットフォーム: iOS、Windows、Web 用のオープンウェイト モデル
クロスプラットフォーム アプリ向けに、Google は MediaPipe タスクと LiteRT を通じて新しい .litertlm モデル バンドルを最適化しました。これには、音声認識用の Parakeet-TDT 0.6B、テキスト読み上げ用の PocketTTS 100M、Kokoro-82M、Phonon 31M が含まれており、iOS、macOS、Windows、Linux、Web 上でコンピューティング競合なしでオンデバイスの小型言語モデルと並行して実行されます。 Hugging Face LiteRT コミュニティでは、Whisper や Qwen3-ASR などのオープンウェイト モデルも提供しています。
ショーケース: オフラインの語学教師とボイスチャット
Google は 2 つの用途をデモしています。1 つは電話上で 100% ローカルで動作する XR Language Teacher ショーケースで、ユーザーが道路標識やメニューにカメラを向け、声に出して質問し、現地の言語での本物の発音で自分の言語での説明を聞くことができます。ストリーミングディクテーションとライブセンテンスハイライト付き読み上げ再生を備えた音声対応AIチャット。この機能は本日より利用可能となり、Android および iOS 上の AI Edge Gallery アプリとオープンソースのリファレンス実装が提供されます。出典: Google 開発者ブログ、2026 年 11 月 10 日。
💬 Comments
No comments yet. Be the first!