 N環球

Google ajoute la reconnaissance vocale et la synthèse vocale hors ligne à AI Edge Gallery
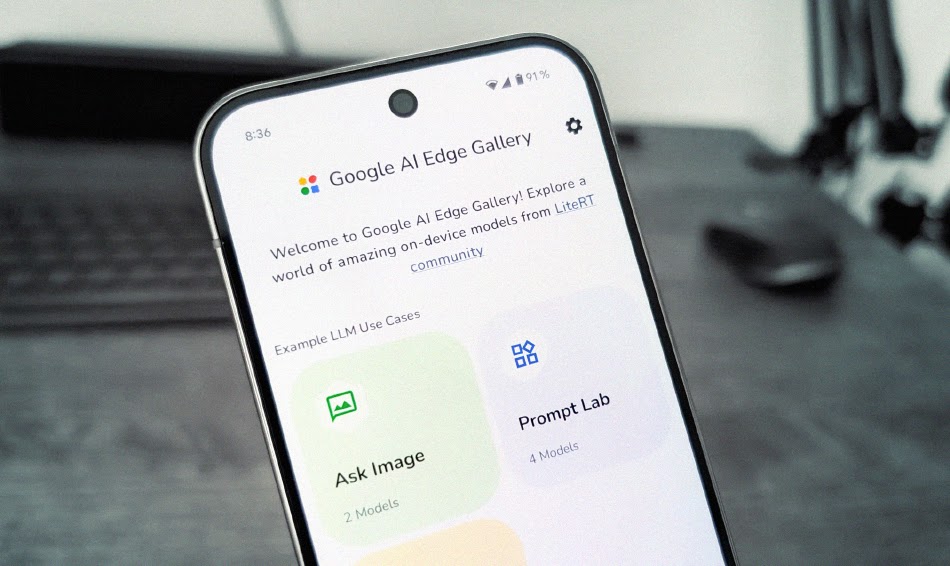
Google a annoncé le 10 novembre qu'AI Edge Gallery prend désormais en charge la reconnaissance automatique de la parole et la synthèse vocale sur l'appareil et hors ligne, associées à de petits modèles comme Gemini Nano et Gemma 4, pour transcrire la parole et lire les réponses à voix haute sans connexion.
Google a annoncé le 10 novembre qu'AI Edge Gallery prend désormais en charge la reconnaissance automatique de la parole (ASR) et la synthèse vocale (TTS) sur l'appareil et hors ligne, associées à de petits modèles de langage comme Gemini Nano et Gemma 4, afin que les téléphones puissent transcrire la parole en direct et lire les réponses à voix haute sans aucune connexion réseau. Selon Google, la voix est souvent le moyen le plus naturel d'interagir avec l'IA sur les téléphones et les objets connectés, et les progrès des modèles vocaux compacts rendent désormais possibles une ASR multilingue précise et une TTS expressive entièrement sur l'appareil.
Android : ML Kit couvre plus de 100 langues et parle en environ 100 ms
Sur Android, les derniers modèles vocaux sur l'appareil de ML Kit transcrivent plus de 100 langues à une vitesse dix fois supérieure au temps réel, avec un taux d'erreur de mots de 8,0 % à 9,0 % sur le test FLEURS. Son modèle de synthèse vocale, fondé sur un modèle de diffusion compact en quelques étapes, commence à parler en environ 100 ms et synthétise un audio de 24 kHz jusqu'à 50 fois plus vite que le temps réel, avec huit voix expressives et 21 paramètres régionaux. Les deux modèles sont intégrés au système d'exploitation, n'ajoutent 0 Mo à l'APK d'une application et bénéficient de l'accélération matérielle des NPU et des TPU lorsqu'elle est disponible.
Multiplateforme : des modèles ouverts pour iOS, Windows et le Web
Pour les applications multiplateformes, Google a optimisé de nouveaux ensembles de modèles .litertlm via MediaPipe Tasks et LiteRT, notamment Parakeet-TDT 0.6B pour la reconnaissance vocale et PocketTTS 100M, Kokoro-82M et Phonon 31M pour la synthèse vocale, fonctionnant sur iOS, macOS, Windows, Linux et le Web aux côtés de petits modèles de langage sur l'appareil, sans conflit de calcul. La communauté Hugging Face LiteRT propose également des modèles ouverts tels que Whisper et Qwen3-ASR.
Démonstrations : un professeur de langue hors ligne et un chat vocal
Google présente deux usages : la démonstration XR Language Teacher, qui fonctionne à 100 % localement sur un téléphone et permet de pointer l'appareil photo vers un panneau ou un menu, de poser une question à voix haute et d'entendre une explication dans sa propre langue avec la prononciation authentique dans la langue locale ; et AI Chat avec la voix, avec dictée en continu et lecture à voix haute accompagnée d'une mise en surbrillance des phrases en direct. Ces fonctionnalités sont disponibles dès aujourd'hui, l'application AI Edge Gallery étant proposée sur Android et iOS et l'implémentation de référence étant en source ouverte. Source : Google Developers Blog, 10 novembre 2026.
💬 Commentaires
Aucun commentaire. Soyez le premier !