 N環球

Google agrega reconocimiento de voz sin conexión y texto a voz a AI Edge Gallery
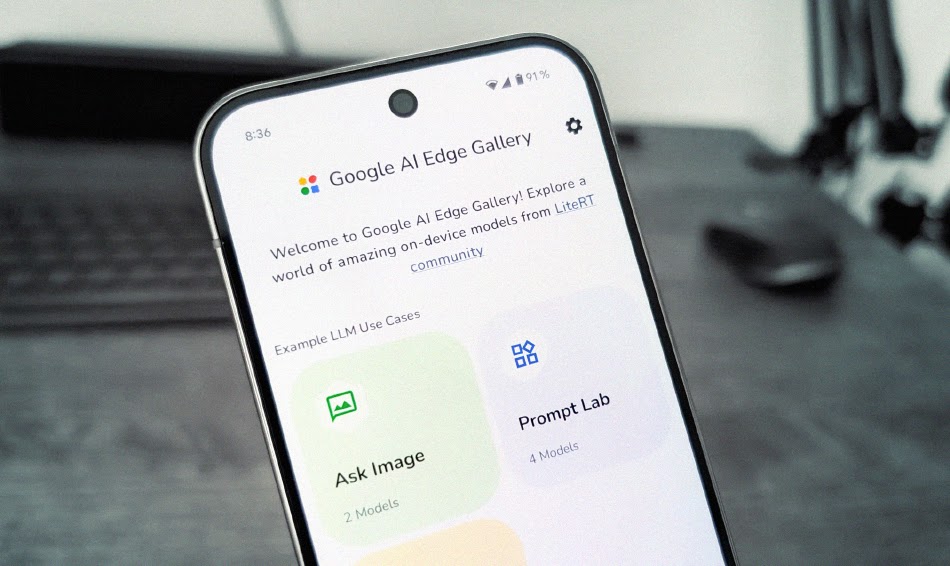
Google dijo el 10 de noviembre que AI Edge Gallery ahora admite reconocimiento de voz automático y texto a voz en el dispositivo, fuera de línea, junto con pequeños modelos en el dispositivo como Gemini Nano y Gemma 4, para que los teléfonos puedan transcribir voz y leer respuestas en voz alta sin una conexión de red.
Google anunció el 10 de noviembre que AI Edge Gallery ahora admite el reconocimiento automático de voz (ASR) y texto a voz (TTS) en el dispositivo, junto con pequeños modelos de lenguaje en el dispositivo como Gemini Nano y Gemma 4, para que los teléfonos puedan transcribir voz en vivo y sintetizar respuestas habladas sin ninguna conexión de red. Google dijo que la voz es a menudo la forma más natural de interactuar con la IA en teléfonos y dispositivos portátiles, y los avances en los modelos de voz compactos ahora hacen posible ASR multilingüe preciso y TTS expresivo completamente en el dispositivo.
Android: ML Kit cubre más de 100 idiomas y comienza a hablar en aproximadamente 100 ms
En Android, los últimos modelos de voz en el dispositivo de ML Kit transcriben más de 100 idiomas a una velocidad 10 veces mayor en tiempo real, alcanzando una tasa de error de palabras del 8,0% al 9,0% en el punto de referencia FLEURS. Su modelo de conversión de texto a voz, impulsado por un modelo compacto de difusión de pocos pasos, comienza a hablar en aproximadamente 100 ms y sintetiza audio de 24 kHz a una velocidad de hasta 50 veces en tiempo real, en ocho voces expresivas y 21 configuraciones regionales. Ambos modelos están integrados en el sistema operativo, agregan 0 MB al APK de una aplicación y se benefician de la aceleración de hardware en los backends NPU y TPU cuando estén disponibles.
Multiplataforma: modelos abiertos para iOS, Windows y la web
Para aplicaciones multiplataforma, Google ha optimizado nuevos paquetes de modelos .litertlm a través de MediaPipe Tasks y LiteRT, incluidos Parakeet-TDT 0.6B para reconocimiento de voz y PocketTTS 100M, Kokoro-82M y Phonon 31M para conversión de texto a voz, que se ejecutan en iOS, macOS, Windows, Linux y la web junto con modelos de lenguaje pequeño en el dispositivo sin contención informática. La comunidad Hugging Face LiteRT también ofrece modelos de peso abierto como Whisper y Qwen3-ASR.
Showcases: un profesor de idiomas fuera de línea y chat de voz
Google está demostrando dos usos: la exhibición XR Language Teacher, que funciona 100% localmente en un teléfono, permitiendo a los usuarios apuntar con una cámara a un letrero o menú de la calle, hacer una pregunta en voz alta y escuchar una explicación en su propio idioma con una pronunciación auténtica en el idioma local; y chat AI habilitado por voz, con dictado en streaming y reproducción de lectura en voz alta con resaltado de frases en vivo. Las funciones están disponibles a partir de hoy, con la aplicación AI Edge Gallery en Android e iOS y la implementación de referencia de código abierto. Fuente: Blog de desarrolladores de Google, 10 de noviembre de 2026.
💬 Comments
No comments yet. Be the first!